مبانی ذخیرهسازی بلوکی
چرا دیتاسنتر به SAN فکر میکند؟
فرض کنید سه سرور HPE ProLiant DL380 دارید و هرکدام ESXi و Datastore محلی خودشان را دارند. حدود ۶۰ ماشین مجازی، از Active Directory و SQL Server تا سرویسهای لینوکسی و برنامههای مالی، روی این سه میزبان پخش شدهاند. اگر یکی از میزبانها برای تعمیر از مدار خارج شود، باید دیسک ماشینهایش را جابهجا کنید یا آنها را از روی نسخهای مستقل برگردانید. در پیکربندیهای پشتیبانیشده میشود ماشین روشن را بدون ذخیرهساز مشترک جابهجا کرد، به شرطی که زمان کپی، ظرفیت مقصد و پهنای باند شبکه را در برنامه نگهداری حساب کرده باشید. اگر میزبان ناگهان خاموش شود، دو میزبان دیگر به دیسک محلی آن دسترسی ندارند. با SAN هر سه میزبان مجاز همان Datastore را میبینند و اگر کلاستر HA آماده باشد، میتواند ماشینها را روی میزبان سالم روشن کند.
با ذخیرهساز مشترک، خرابی یک سرور لزوماً دسترسی به دیسک ماشینها را قطع نمیکند. در عوض، سلامت آرایه و Fabric روی هر سه میزبان اثر میگذارد. قبل از خرید مشخص کنید در زمان خرابی چقدر ظرفیت لازم دارید، سرویسها باید چه مدت بعد برگردند، دادهها با چه سرعتی رشد میکنند و بکاپ کجا نگهداری میشود. اگر آرایه از دست برود، برای برگرداندن فایلهای VM به نسخهای مستقل از آن نیاز دارید.
SAN چیست و درخواست I/O از کجا عبور میکند؟
Storage Area Network شبکه و سازوکار ارائه ذخیرهسازی بلوکی به میزبان است. دیسکها یا SSDها پشت کنترلر آرایه قرار دارند. کنترلر ظرفیت محافظتشده را بهصورت Volume به میزبان مجاز ارائه میکند. میزبان درخواست خواندن یا نوشتن آدرس بلوک منطقی را به Target میفرستد و آرایه آن را به محل داده یا Cache نگاشت میکند. محفظه دیسک تنها یکی از اجزای این معماری است. Fabric میتواند مبتنی بر Fibre Channel یا شبکه IP متناسب با پروتکل باشد.
مقایسه SAN، NAS و DAS
| ویژگی | DAS | NAS | SAN |
|---|---|---|---|
| سطح دسترسی | بلوک محلی | فایل از راه شبکه | بلوک از راه شبکه |
| پروتکل رایج | SAS، SATA، NVMe/PCIe | SMB، NFS | FC/FCP، iSCSI، NVMe-oF |
| مالک فایلسیستم | سیستمعامل میزبان | سرویس NAS | میزبان یا کلاستر مصرفکننده |
| مرز کارایی | کنترلر و رسانه محلی | شبکه، سرویس فایل و رسانه | Fabric، مسیرها، کنترلر و Pool |
| مقیاس و مدیریت | توسعه سرور یا JBOD | افزودن ظرفیت یا Node طبق طراحی | توسعه آرایه، Fabric و ظرفیت مسیر |
| افزونگی | کنترلر یا RAID محلی حسب مدل | گره و شبکه و دیسک حسب مدل | مسیر، Fabric، کنترلر و حفاظت رسانه |
| کاربرد | Boot، Cache، بار مستقل | اشتراک فایل و Datastore مبتنی بر NFS | VMFS، پایگاه داده و دیسک کلاستر |
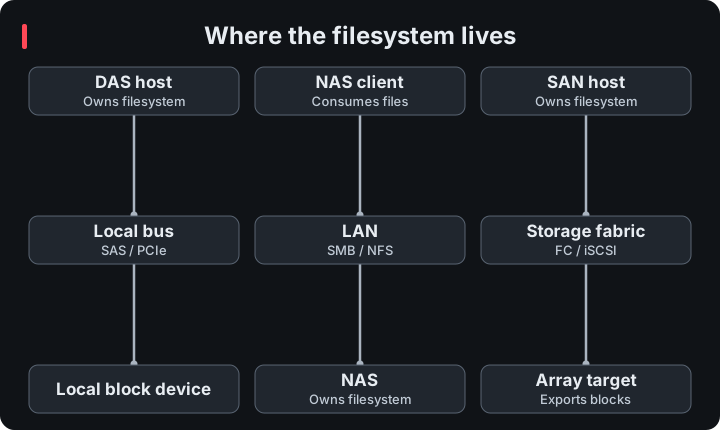
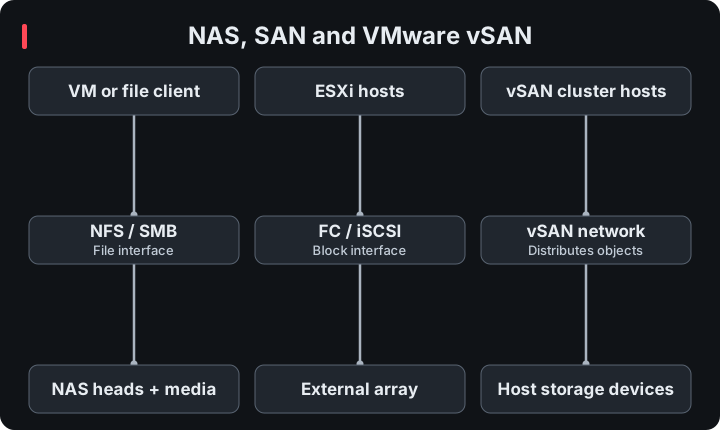
برای اشتراک پوشه کاربران، SMB معمولاً مسئله را مستقیمتر حل میکند. برای VMFS روی دیسک مشترک، میزبان به دستگاه بلوکی نیاز دارد. یک محصول Unified میتواند هر دو سرویس را ارائه کند. برای انتخاب، ببینید میزبان به فایل نیاز دارد یا دستگاه بلوکی و خرابی هر جزء دسترسی کدام سرویسها را قطع میکند.
دستگاه بلوکی، Volume و فایلسیستم
میزبان یک دستگاه با آدرسهای منطقی بلوک میبیند و میتواند روی آن جدول پارتیشن و فایلسیستم بسازد. فرمانهای SCSI مانند READ و WRITE روی دستگاه منطقی عمل میکنند. LUN شمارهای برای شناسایی واحد منطقی در زمینه ارائه Target است. در زبان عملیاتی، خود دستگاه ارائهشده را هم LUN مینامند. شناسه پایدار دستگاه را کنار شماره LUN ثبت کنید. Thin و Thick نحوه تخصیص ظرفیت را تعیین میکنند و شکل دستگاه بلوکی از دید مهمان میتواند در هر دو یکسان باشد. اتصال یک LUN به دو سرور به آنها دید مشترک به بلوک میدهد. هماهنگی نوشتن به فایلسیستم کلاستری یا کنترل مالکیت نیاز دارد.
سختافزار و معماری آرایه
اجزای فیزیکی
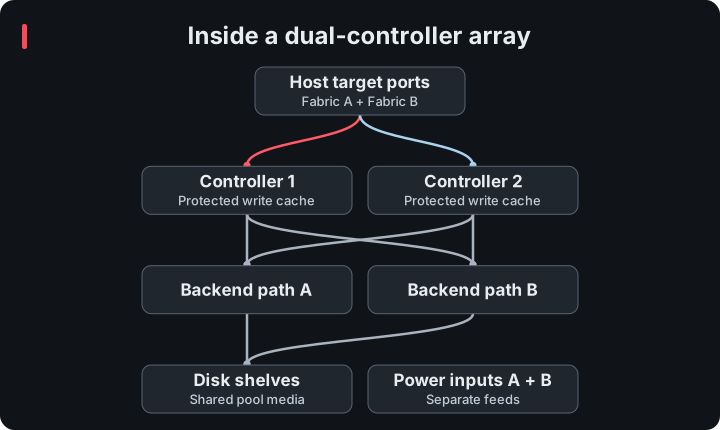
آرایه شامل کنترلرهای Front-end، رسانه و مسیرهای Backend است. Shelf توسعه از رابط و توپولوژی تعریفشده سازنده استفاده میکند و خرابی مسیر SAS یا Backend را باید جدا از قطع Fabric بررسی کرد. HDD برای ظرفیت و الگوی مناسب، SSD برای دسترسی سریعتر و NVMe برای رابط فرمان و صف متفاوت در نظر گرفته میشود. نوع رسانه داخلی لزوماً پروتکل اتصال میزبان را تعیین نمیکند.
در FC، آداپتور میزبان HBA به سوئیچ FC متصل میشود. در iSCSI نرمافزاری، NIC اترنت ترافیک IP را حمل میکند. شکل ظاهری ماژول برای سازگاری کافی نیست. SFP، SFP+، SFP28 و ماژولهای FC را با فهرست سازگاری پورت، سرعت، طول موج، نوع فیبر و فاصله تطبیق دهید. DAC فقط در پورتها و طولهای تأییدشده کاربرد دارد. دو منبع تغذیه را روی دو مسیر برق مستقل قرار دهید. وضعیت فن، دما و پورت مدیریت خارج از مسیر داده نیز جزو پذیرش نصب است.
کنترلر، کش و مالکیت Volume
در معماری دوکنترلره، هر دو کنترلر ممکن است همزمان برای Volumeهای گوناگون I/O سرو کنند. برای یک Volume مشخص، مسیر به کنترلر مالک میتواند بهینهتر باشد. در طرح Active-passive کنترلر یا مسیر Standby پس از رخداد مشخص وارد سرویس میشود. رفتار مالکیت، توازن بار و برگشت خودکار را از راهنمای همان مدل بررسی کنید.
در Write-back، تأیید نوشتن میتواند پیش از انتقال داده به رسانه صادر شود. حفظ داده تأییدشده به سازوکار حفاظت Cache وابسته است. پیادهسازیها میتوانند Cache آینهشده، حافظه پایدار یا Supercapacitor و انتقال به Flash داشته باشند. Write-through تأیید را تا مرحله پایدار تعریفشده در دستگاه عقب میاندازد. افت سلامت حفاظت Cache ممکن است سیاست نوشتن را عوض کند و پیش از ظاهر شدن خرابی دیسک، تأخیر را بالا ببرد.
مسیر کامل I/O
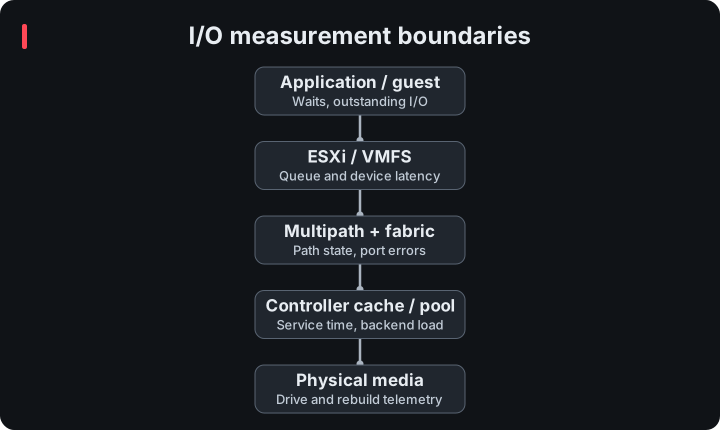
Application درخواست را از فایلسیستم و Storage Stack مهمان عبور میدهد. در محیط مجازی، Hypervisor درخواست VMDK را به I/O روی VMFS تبدیل میکند. Multipath مسیر قابل استفاده را به HBA یا NIC انتخاب میکند. Fabric درخواست را به پورت Target میرساند. کنترلر بر اساس نگاشت، Cache و حفاظت RAID آن را روی Pool و رسانه پردازش میکند. پاسخ از همین زنجیره برمیگردد. در عیبیابی زمان رخداد هر مرز را جداگانه ثبت کنید.
خانوادههای سختافزاری
HPE MSA و Dell PowerVault ME را در رده آرایههای بلوکی برای استقرارهای کوچکتر بررسی کنید. برای نیازهای توسعه و عملیات سازمانی، خانوادههای HPE Alletra، Dell PowerStore، IBM FlashSystem و NetApp AFF گزینههای بررسی هستند. Dell Unity XT نیز در محیطهای نصبشده و پروژههای تمدید اهمیت دارد. برای تصمیم خرید، مدل و نسل دقیق، وضعیت سفارش و پایان پشتیبانی، گزینههای FC یا iSCSI یا NVMe-oF، رسانه، مجوز Replication و ماتریس سازگاری را کتبی دریافت کنید. اسم خانواده برای تعیین قابلیت یا مسیر ارتقا کافی نیست.
ارائه ذخیرهسازی SAN در NetApp ONTAP
Fibre Channel، iSCSI و NVMe-oF
Fibre Channel از ورود به Fabric تا انتقال داده
پورت N میزبان یا آرایه معمولاً به پورت F سوئیچ وصل میشود. E_Port به اتصال بین سوئیچها تعلق دارد. در ورود به Fabric، FLOGI و تخصیص FCID انجام میشود. FCID آدرس عملیاتی است و میتواند تغییر کند. WWNN شناسه Node و WWPN شناسه پورت است. Name Server اطلاعات پورتهای ثبتشده را در محدوده سیاست Fabric ارائه میکند. ارتباط پورتها و ایجاد ارتباط پروتکلی پس از کشف انجام میشود و FCP فرمانهای SCSI را حمل میکند. Frame و سازوکار Credit در لایه FC قرار دارند. سرعت، نسل پورت، ماژول و رسانه باید با هم سازگار باشند. سرعت اسمی لینک را با نرخ مفید کاربر و ظرفیت حالت خرابی یکی نگیرید.
Zoning و LUN Masking
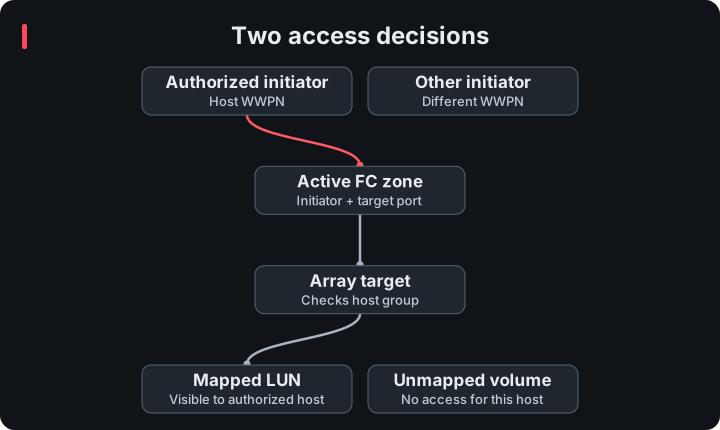
در نمونه Fabric A، WWPN پورت A از ESXi-01 را با WWPN پورت A کنترلر ۱ در یک Zone قرار دهید و اگر طراحی سازنده چنین میخواهد، برای پورت کنترلر ۲ Zone جدا تعریف کنید. همین الگو را با WWPNهای B در Fabric B پیاده کنید. Zone اعضای مجاز برای ارتباط را تعیین میکند، Zoneset فعال مجموعه سیاست اجرایی است و حالت Zone پیشفرض باید بررسی شود. Zoning مبتنی بر پورت سوئیچ، عضویت را به محل اتصال وابسته میکند و جابهجایی کابل بر آن اثر دارد. در آرایه، Host Group جداگانه تعیین میکند همان Initiator به کدام Volume دسترسی دارد. پس از تعویض HBA، هم Alias و Zone و هم Host Mapping را بازبینی کنید.
راهنمای Zoning در Cisco MDS NX-OS 9.x
سختسازی سوئیچهای Cisco Catalyst در Meet AJ
iSCSI روی TCP/IP
Initiator با نامی مانند IQN به Target و Portal آن متصل میشود. Portal ترکیب آدرس و پورت است و TCP 3260 پورت پیشفرض iSCSI است. کشف میتواند با آدرس ثابت یا SendTargets انجام شود. کشف هدف، Login موفق و مشاهده LUN سه مرحله مستقلاند. CHAP احراز هویت انجام میدهد. شبکه ایزوله دسترسی شبکهای را محدود میکند. اگر محرمانگی رمزنگاریشده Payload لازم است، از سازوکار جداگانه و پشتیبانیشده مانند IPsec استفاده کنید. یک Session به رابطه Initiator و Target تعلق دارد و مفهوم Session با مسیر قابل استفاده MPIO یکسان نیست.
استاندارد IETF برای iSCSI و رفتار Login، Session و CHAP
طراحی شبکه iSCSI
برای A و B دو شبکه داده مستقل و مسیرهای مدیریت جدا در نظر بگیرید. VLAN جداسازی منطقی است و ظرفیت، برق یا ASIC مشترک را مستقل نمیکند. MTU عادی مبنای خوبی برای پذیرش است. اگر Jumbo Frame انتخاب شد، مسیر کامل و هر دو جهت را با اندازه مناسب و بدون Fragmentation آزمایش کنید. Packet loss، retransmission، Drop صف و Pause را روی همان پورتها و همان زمان بررسی کنید. تنظیم Flow Control، QoS و رفتار شبکه همگرا را بر اساس راهنمای ترکیب سوئیچ و آرایه انجام دهید.
LACP میتواند ظرفیت مجموع جریانها و بقای لینک را در یک دامنه فراهم کند. انتخاب مسیر SCSI، کشف Target و بقای مستقل دو Switch از مسئولیتهای MPIO و طراحی شبکه است. Routing تنها وقتی وارد طرح شود که توپولوژی، مسیر برگشت، MTU و پشتیبانی سازنده مشخص باشند. در ESXi، Port Binding برای شرایط خاص Software iSCSI است. برای مثال دو Subnet مستقل این مقاله، Port Binding مشترک در نظر گرفته نشده است.
شرایط Software iSCSI Port Binding در Broadcom
مقایسه FC و iSCSI
| معیار | Fibre Channel | iSCSI |
|---|---|---|
| انتقال | Frame در Fabric و FCP | SCSI روی TCP/IP |
| تجهیزات | HBA، سوئیچ و اپتیک FC | NIC یا آداپتور مناسب، سوئیچ و رسانه Ethernet |
| دسترسی | WWPN، Zone، Host Mapping | IQN، Portal، CHAP، Host Mapping |
| گلوگاه نمونه | Credit، ISL، پورت کند | Drop، Retransmit، ازدحام صف، MTU |
| هزینه عملیاتی | تجهیز و تخصص Fabric اختصاصی | مدیریت جداسازی و ظرفیت در زیرساخت IP |
| سناریو | سازمان با Fabric موجود و تیم FC | مرکز داده با شبکه IP مهندسیشده و پشتیبانی آرایه |
مقایسه را با تأخیر دنباله، اندازه بلوک، بار همزمان، میزان Cache hit، هزینه CPU و ظرفیت پس از قطع یک Fabric انجام دهید. از پشتیبانی فروشنده برای کل زنجیره، شامل Driver و Firmware و نسخه Hypervisor، اطمینان بگیرید.
NVMe over Fabrics
NVMe از مدل صف و مجموعه فرمان متفاوت با SCSI استفاده میکند. میزبان به Subsystem متصل میشود و Namespace مصرف میکند. NVMe/TCP از TCP، NVMe/FC از Fabric مبتنی بر FC و NVMe/RDMA از انتقال RDMA پشتیبانیشده استفاده میکند. تنظیم شبکه RDMA به نوع انتقال و طراحی وابسته است. ANA وضعیت دسترسی نامتقارن Namespace را گزارش میکند. برای مهاجرت، پشتیبانی مشترک Initiator، آداپتور، آرایه، Multipath، نسخه OS و ابزار پایش را بررسی کنید. سود تأخیر با اندازهگیری در بار واقعی، بهویژه در صدکهای بالا، مشخص میشود.
RAID، ظرفیت منطقی و Snapshot
RAID و هزینه محافظت از داده
| سطح | چیدمان | ظرفیت اسمی با N دیسک هماندازه S | تحمل خرابی و کاربرد |
|---|---|---|---|
| RAID 0 | Stripe بدون افزونگی | N × S | خرابی هر عضو داده را از بین میبرد؛ داده موقت و بازتولیدپذیر |
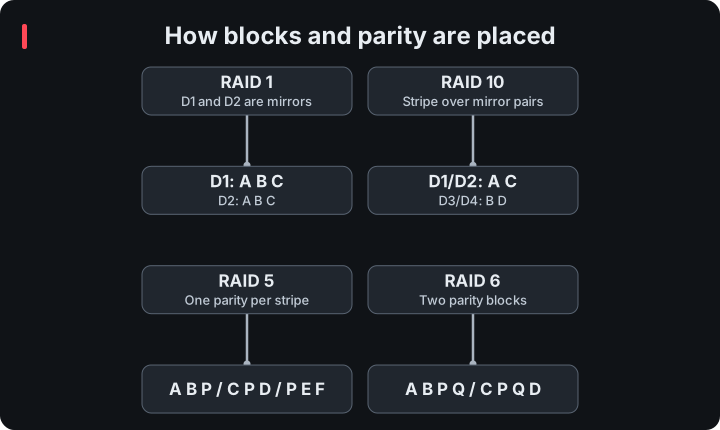
| RAID 1 | آینه دو عضوی | S | تحمل یک عضو از جفت؛ Volume کوچک یا Boot حسب مدل |
| RAID 5 | Stripe با یک Parity | (N−1) × S | تحمل یک عضو؛ بررسی بار نوشتن و مدت Rebuild |
| RAID 6 | Stripe با دو Parity | (N−2) × S | تحمل دو عضو؛ فضای محافظتی بیشتر برای Poolهای ظرفیتمحور |
| RAID 10 | Stripe روی جفتهای آینه | N × S ÷ 2 | تحمل یک خرابی در هر جفت؛ خرابی هر دو عضو یک جفت خطر از دست رفتن گروه دارد |
در RAID دارای Parity، نوشتن کوچک میتواند خواندن داده و Parity قدیم و نوشتن هر دو را لازم کند. Full-stripe، Cache و روش داخلی آرایه این هزینه را تغییر میدهند. Rebuild با I/O برنامه بر سر رسانه، Backend و کنترلر رقابت میکند. در RAID 10 بازسازی معمولاً از عضو آینه انجام میشود. در RAID 5 و 6 بازیابی داده یک عضو میتواند از چند عضو بخواند. انتخاب را با ظرفیت مؤثر، پروفایل بار و رفتار مشاهدهشده در حالت Degraded انجام دهید.
حفاظت توزیعشده
Distributed RAID و Dynamic Disk Pool میتوانند قطعات داده، Parity و ظرفیت بازسازی را در سطح مجموعه بزرگتری پخش کنند. Erasure Coding داده را به قطعات داده و بازیابی تبدیل میکند و سیاست توزیع آن تعیین میکند کدام خرابیها قابل تحملاند. اصطلاح DDP را تنها برای محصولی به کار ببرید که همین نام و رفتار مستند را دارد. برای مقایسه، تعداد خرابی قابل تحمل در همان Failure Domain و ظرفیت رزرو بازسازی را بخواهید.
نمونه رفتار Distributed RAID در IBM FlashSystem
Pool، Volume، LUN و ارائه به میزبان
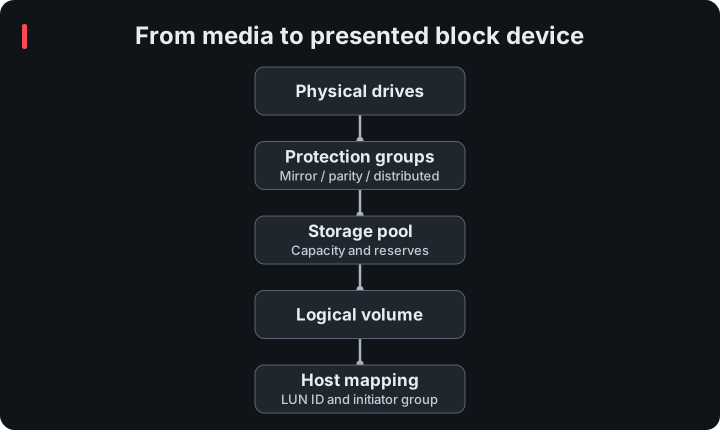
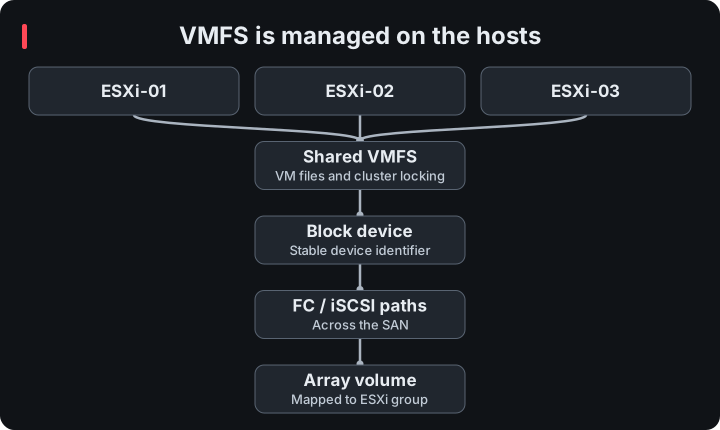
ظرفیت رسانه پس از حفاظت و رزرو وارد Pool میشود. Volume از Pool ظرفیت میگیرد. هنگام ارائه Volume به Initiator Group، آرایه یک نگاشت و LUN ID تعیین میکند. همان Volume ممکن است از چند Target Port دیده شود و Multipath آن را بهعنوان یک دستگاه واحد تشخیص دهد. برای VMFS مشترک، هر سه میزبان را در گروه صحیح قرار دهید و شناسه پایدار دستگاه را از همه میزبانها تطبیق دهید. Clone و Volume تولید باید شناسه مستقل و سیاست ارائه روشن داشته باشند.
Thin، Thick و UNMAP
Thin در زمان نوشتن، ظرفیت فیزیکی تخصیص میدهد. Thick در لایه مربوط ظرفیت را از پیش رزرو میکند، با جزئیات وابسته به محصول. VMDK و Volume آرایه دو لایه مستقلاند. حذف فایل در مهمان زمانی به کاهش ظرفیت مصرفی آرایه کمک میکند که زنجیره فایلسیستم، Hypervisor و آرایه فرمان بازپسگیری مناسب مانند SCSI UNMAP را پشتیبانی و عبور دهد. Snapshot میتواند بلوکها را همچنان نگه دارد. علاوه بر ظرفیت ارائهشده، مصرف واقعی، سرعت رشد و زمان باقیمانده تا پرشدن Pool را پایش کنید.
Snapshot و Clone
Array Snapshot معمولاً نقطهای از نگاشت بلوک را حفظ میکند. Copy-on-write پیش از بازنویسی نسخه قدیم را نگه میدارد و Redirect-on-write نوشتن جدید را به محل تازه میفرستد. جزئیات Metadata و ظرفیت به محصول وابسته است. VMware Snapshot تغییرات دیسک VM را در زنجیره Delta نگه میدارد و حذف آن میتواند Consolidation و بار I/O ایجاد کند. برای سازگاری برنامه، از هماهنگی VSS یا ابزار سازگار با محصول استفاده کنید و Restore را بررسی کنید. Clone میتواند وابسته یا مستقل باشد. نگهداری Snapshot را به ظرفیت و بازیابی گره بزنید و یک کپی قابل بازیابی در دامنه دیگری داشته باشید.
طراحی دو Fabric و Multipathing
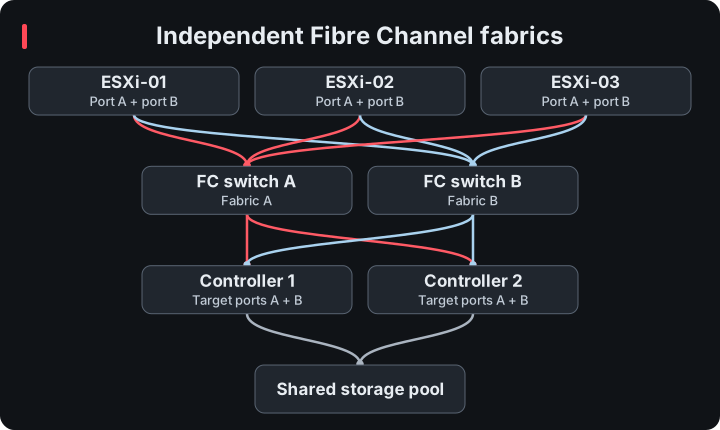
Fibre Channel با سه میزبان
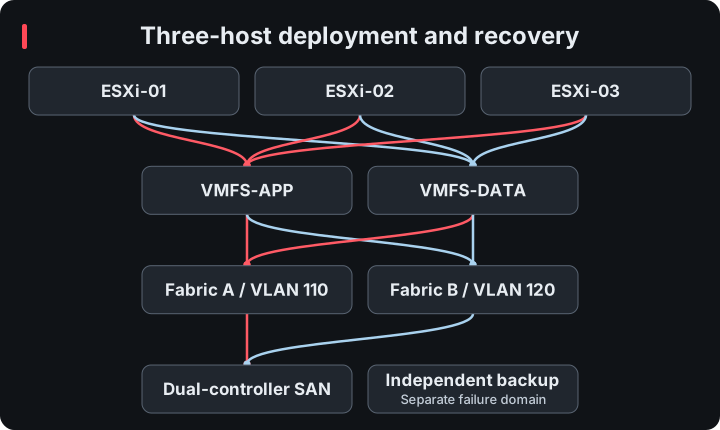
در طرح فرضی، هر DL380 یک پورت FC به Switch A و یک پورت به Switch B دارد. روی هر کنترلر آرایه یک Target Port به A و یک Target Port به B وصل است. Fabricها به هم ISL ندارند. WWPN هر اتصال در جدول کابل و Zone ثبت میشود. HBA دوپورته مسیر پورت و Fabric را جدا میکند، اما خرابی خود کارت هر دو را میگیرد. اگر خرابی کارت باید تحمل شود، پورتها را با دو HBA مستقل و توپولوژی پشتیبانیشده طراحی کنید.
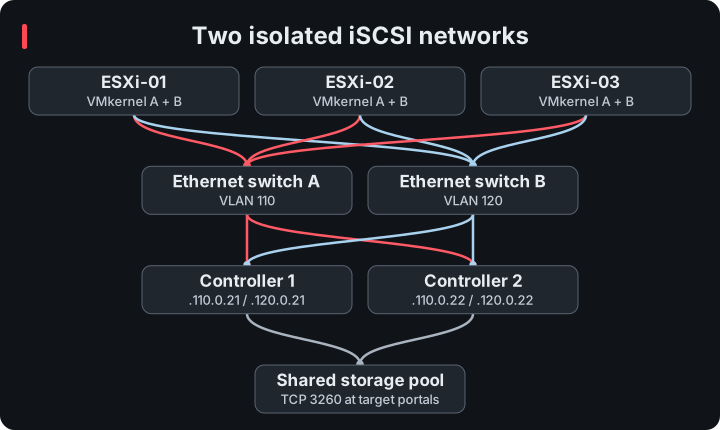
iSCSI با دو شبکه مستقل
این نشانیها نمونهاند. در هر میزبان، یک VMkernel روی uplink A و یک VMkernel روی uplink B تعریف کنید و مسیر دسترسی Portalها را قبل از Discovery تأیید کنید. شبکه مدیریت vCenter و آرایه از این VLANها جداست.
| رابط | شبکه A، VLAN 110، 10.110.0.0/24 | شبکه B، VLAN 120، 10.120.0.0/24 |
|---|---|---|
| ESXi-01 | 10.110.0.11 | 10.120.0.11 |
| ESXi-02 | 10.110.0.12 | 10.120.0.12 |
| ESXi-03 | 10.110.0.13 | 10.120.0.13 |
| کنترلر ۱ | 10.110.0.21 | 10.120.0.21 |
| کنترلر ۲ | 10.110.0.22 | 10.120.0.22 |
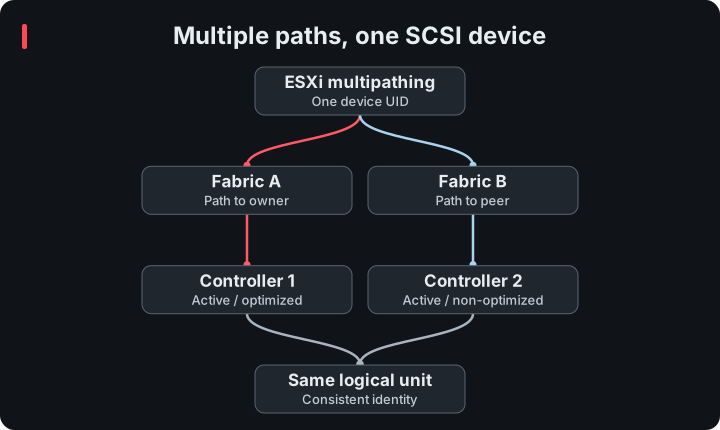
انتخاب مسیر و حالت ALUA
لایه Multipath مسیرهای ارائه یک Device را گروهبندی و مسیر مناسب را انتخاب میکند. در SCSI، ALUA وضعیت دسترسی گروه پورت Target را از جمله Active/Optimized و Active/Non-Optimized توصیف میکند. مسیر غیربهینه ممکن است I/O را از طریق کنترلر دیگر عبور دهد. در NMP، Round Robin، Fixed و Most Recently Used رفتار انتخاب متفاوت دارند. نوع Plugin و Policy را با راهنمای آرایه و ESXi تطبیق دهید. شمار زیاد مسیر سالم جای بررسی توزیع مسیر بین Fabricها را نمیگیرد.
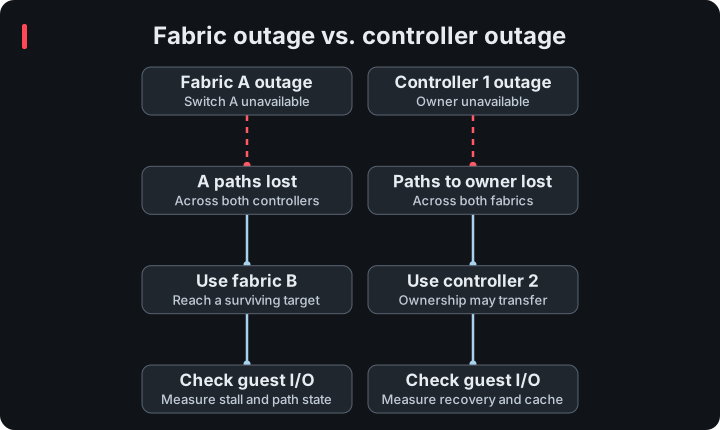
رفتار در خرابی مسیر
قطع کابل، خرابی SFP یا پورت، مسیر همان اتصال را حذف میکند. قطع Switch A تمام مسیرهای A را میگیرد. خرابی کنترلر ممکن است تغییر Ownership و مکث I/O داشته باشد. خطای شبکه میتواند به شکل Drop متناوب و نه Link Down دیده شود. میزبان تا زمان تشخیص Timeout و جابهجایی صف ممکن است مکث محسوسی داشته باشد. بعد از بازگشت مسیر، وضعیت و پایداری پس از چند نمونه تلهمتری را بررسی کنید. اگر مسیر باقیمانده اشباع باشد یا مسیرهای A و B به برق مشترک متکی باشند، افزونگی ظاهری کافی نیست.
اتصال SAN به VMware ESXi
Fibre Channel و iSCSI در ESXi
برای FC ابتدا نسخه ESXi، HBA، Driver و Firmware، آرایه، سوئیچ و سیاست Multipath را در ماتریس سازگاری کنترل کنید. HBA و Fabric را نصب و Login پورتها را بررسی کنید. Zoneهای هر Fabric را فعال کنید، Volume را بسازید و به Host Group ارائه دهید. Rescan را در میزبانهای هدف انجام دهید و قبل از ایجاد VMFS، شناسه دستگاه و مسیرهای هر میزبان را ثبت کنید. Datastore جدید را یکبار روی LUN خالی بسازید و همان VMFS را در میزبانهای دیگر شناسایی کنید.
برای iSCSI ابتدا VMkernel و Uplink را راهاندازی کنید. آداپتور مناسب را فعال کنید، Portalها و احراز هویت را طبق دستورالعمل آرایه اضافه کنید و دسترسی Initiator را محدود کنید. پس از Rescan، Target، شناسه ثابت دستگاه و مسیرها را تطبیق دهید. بعد از ساخت یا Mount، I/O آزمایشی و قطع کنترلشده یک مسیر را اجرا کنید. اتصال TCP یا دیده شدن Portal به معنی آماده بودن Datastore نیست.
نصب و تنظیم پایه ESXi 8 در Meet AJ
VMFS، قفل و توسعه ظرفیت
VMFS فایلسیستم کلاستری است و دسترسی چند میزبان به فایلهای VM را با قفل و سازوکارهای هماهنگی کنترل میکند. VMDK، فایل تنظیمات و Snapshot VM در Datastore قرار میگیرند. برای افزایش ظرفیت، ابتدا سمت آرایه را توسعه دهید، همه میزبانها را Rescan کنید و VMFS را با رویه پشتیبانیشده گسترش دهید. قبل از عملیات شناسه NAA، اندازه و مالک Datastore را ثبت کنید. مشاهده Signature تکراری بعد از ارائه Snapshot یا Clone نیاز به بررسی دارد و ایجاد دوباره Datastore میتواند داده را از بین ببرد.
HA، vMotion و Storage vMotion
vSphere HA با دسترسی به فایلهای VM و ظرفیت میزبان مقصد، VM را بعد از خرابی دوباره اجرا میکند. vMotion جابهجایی اجرای VM است. در سناریوهای تأییدشده، مهاجرت همزمان Compute و Storage بدون Datastore مشترک نیز ممکن است. Storage vMotion فایلهای VM را بین Datastoreهای مجاز جابهجا میکند. پشتیبانی هر عملیات به نسخه، پیکربندی شبکه، ویژگی VM و مجوز وابسته است. خرابی کامل SAN برای VMهای متکی به همان آرایه با HA میزبان برطرف نمیشود.
مقایسه ذخیرهسازی و HA در VMware و Proxmox
معماری VMware vSAN روی ذخیرهساز داخلی میزبانها
عیبیابی مسیر در ESXi
esxcli storage core adapter list
esxcli storage core device list
esxcli storage core path list
فرمان اول vmhba و Driver را نشان میدهد. خروجی Device را با شناسه ثبتشده و Vendor و اندازه تطبیق دهید. خروجی Path را بر مبنای Device، آداپتور، هدف و State مقایسه کنید. اگر Device موجود است ولی مسیر دوم نیست، مشکل را از مسیر مشخص دنبال کنید. اگر هیچکدام موجود نیست، ابتدا Link و Login یا Session را بررسی کنید و سپس Zone و Mapping را مقایسه کنید. مسیرهایی که مرتب Dead و Active میشوند را با لاگ vmkernel و شمارنده پورت همزمان کنید.
APD یعنی همه مسیرها از دست رفتهاند و میزبان نشانه قطعی دائمی بودن عدم دسترسی دریافت نکرده است. PDL پس از تشخیص عدم دسترسی دائمی، مثلاً با پاسخ SCSI مناسب، رخ میدهد. تصمیم برای بازیابی اتصال، Restart یا واکنش VM Component Protection را با وضعیت واقعی Device و سیاست کلاستر بگیرید. قبل از بازگرداندن LUN، شناسه و Mapping سابق را تأیید کنید.
Windows Server، MPIO و Failover Clustering
اتصال در Windows Server 2025
در Server Manager قابلیت Multipath I/O را بههمراه DSM پشتیبانیشده نصب کنید. Restart احتمالی را در پنجره تغییر انجام دهید. برای iSCSI، سرویس Initiator، Portalها و Sessionهای مجزا با Source IP درست را طبق راهنمای آرایه تنظیم کنید. برای FC شناسه پورت و Zone را بررسی کنید. دیسک ارائهشده را با شناسه یکتا، اندازه و Mapping ثبتشده تطبیق دهید. هنگام راهاندازی دیسک تازه و تأییدشده، GPT و فایلسیستم موردنیاز برنامه را انتخاب کنید. دیسک تولید یا دیسک عضو کلاستر را Initialize، Format یا بهزور Online نکنید.
Get-WindowsFeature Multipath-IO
Get-IscsiSession
Get-IscsiConnection
Get-Disk | Select-Object Number,FriendlyName,UniqueId,PartitionStyle,OperationalStatus
Get-MPIOSetting
mpclaim -s -dWindows Server MPIO و صحت مسیر
Get-WindowsFeature وضعیت نصب را نشان میدهد. Get-IscsiSession رابطه Initiator و Target و Get-IscsiConnection اتصالهای TCP را بررسی میکند. Get-Disk شناسه و وضعیت دستگاه را میدهد. Get-MPIOSetting تنظیمات عمومی و mpclaim دیسکهای Claimشده را نشان میدهند. برای وضعیت مسیر هر دیسک، گزارش تفصیلی DSM و ابزار مدیریت آرایه را بررسی کنید. چند نمونه از یک دیسک در Disk Management میتواند نشانه Claim نشدن درست مسیرها باشد. سیاست Microsoft DSM یا DSM سازنده را با مدل و Firmware مطابقت دهید. قطع آزمایشی تک مسیر را با اندازهگیری خطا و زمان بازیابی انجام دهید.
عیبیابی MPIO در Microsoft Learn
مرجع فرمانهای iSCSI در Windows Server 2025
دیسک مشترک، CSV و Quorum
در Failover Clustering، Cluster Validation را برای ترکیب Node و Storage اجرا کنید و آزمونهایی را که ممکن است دسترسی دیسک را مختل کنند برای پنجره مجاز برنامهریزی کنید. در سناریوهای دیسک مشترک سازگار، SCSI-3 Persistent Reservations در هماهنگی دسترسی نقش دارد. دیسک کلاستری معمولی تحت مالکیت نقش مربوط قرار میگیرد. CSV دسترسی هماهنگ چند Node به Volume را برای بارهای پشتیبانیشده فراهم میکند. برای Quorum، مدل رأی و Witness را با Failure Domainها تطبیق دهید. یک NTFS عادی که خارج از کلاستر همزمان برای چند نویسنده Online شود میتواند آسیب ببیند.
طراحی ذخیرهسازی SQL Server
Data، Log، TempDB و Backup
الگوی OLTP میتواند خواندن تصادفی صفحات داده و نوشتن حساس به تأخیر روی Log داشته باشد. Log معمولاً به شکل ترتیبی نوشته میشود و زمان Flush در مسیر Commit مهم است. TempDB با Sort، Spill و بارهای موقت الگوی متغیر دارد. Backup میتواند پهنای باند زیادی با خواندن Data و نوشتن مقصد مصرف کند. برای هر فایل، تعداد I/O و مجموع زمان Stall را در دو نمونه از sys.dm_io_virtual_file_stats بگیرید. اختلاف زمان Stall تقسیم بر اختلاف تعداد عملیات، میانگین همان بازه را میدهد. Waitهای WRITELOG و PAGEIOLATCH را با PerfMon و تلهمتری آرایه تطبیق دهید. Blocking و تغییر Query Plan را نیز با شواهد مستقل بررسی کنید.
جدا کردن Volume چه زمانی اثر دارد؟
Volumeهای مجزا امکان پایش جداگانه، سیاست QoS، Snapshot و تخصیص ظرفیت مستقل را فراهم میکنند. اگر Volumeها در یک Pool و روی یک کنترلر باشند، Cache، رسانه و Queue میتوانند مشترک بمانند. برای ایزولهکردن بار Log از Backup، زمانبندی، QoS معتبر یا جداسازی واقعی منابع را با داده همزمان آزمایش کنید. علاوه بر میانگین، جهشهای تأخیر و زمانبندی Jobها را ببینید. افزایش Queue Depth ممکن است ظرفیت مصرفی یک میزبان را بالا ببرد و همزمان زمان انتظار سایر میزبانها را بدتر کند.
روش Microsoft برای بررسی تأخیر I/O در SQL Server
زمانبندی و عملیات بکاپ SQL Server
Always On Availability Groups و FCI
Availability Group نسخههای مستقل پایگاه داده را روی Replicaها نگه میدارد و Log را به Replica منتقل میکند. طراحی معمول AG یک LUN مشترک بین Replicaها لازم ندارد و میتواند با دو سامانه ذخیرهسازی مستقل از خرابی آرایه نیز عبور کند. FCI سرویس Instance را به Node دیگر منتقل میکند و به فضای مشترک یا راهکار ذخیرهسازی پشتیبانیشده برای آن نقش متکی است. در FCI با SAN، خرابی کامل همان SAN میتواند دسترسی Instance را در همه Nodeها قطع کند. RPO، وضعیت همگامسازی، Quorum و مسیر اتصال Client را جداگانه آزمایش کنید.
مهندسی کارایی و عیبیابی تأخیر
اعداد را در یک بازه تفسیر کنید
IOPS تعداد عملیات در ثانیه، Throughput حجم منتقلشده در ثانیه، Latency زمان هر درخواست و Queue Depth تعداد درخواستهای معوق است. در مثال محاسباتی، ۱۰٬۰۰۰ عملیات بر ثانیه با اندازه ثابت ۸ KiB حدود ۷۸٫۱ MiB/s داده کاربر است. همان IOPS با اندازه ۶۴ KiB حدود ۶۲۵ MiB/s میشود. این اعداد نرخ سیم یا نتیجه آزمون نیستند. نسبت خواندن به نوشتن، ترتیبی یا تصادفی بودن، Cache hit و مدت بار را کنار اعداد ثبت کنید. با افزایش صف، IOPS میتواند مدتی بالا برود و در همان زمان صدک ۹۹ تأخیر بدتر شود.
اندازهگیری در مرزهای مختلف
از زمان و دامنه رخداد شروع کنید. اگر فقط یک VM کند است، صف مهمان، فایل، Query و کنترلر مجازی را مقایسه کنید. اگر همه VMهای یک میزبان درگیرند، Uplink، HBA و صف آن میزبان را بررسی کنید. اگر چند میزبان روی یک Volume همزمان متأثرند، Device، Fabric و کنترلر مالک را بررسی کنید. در esxtop، DAVG تأخیر سمت دستگاه از دید میزبان، KAVG زمان در لایه Kernel و GAVG تأخیر ذخیرهسازی مجازی ارائهشده به مهمان را از سمت ESXi گزارش میکند. برای صف و پردازش داخل سیستمعامل مهمان باید از کانترهای همان سیستمعامل یا برنامه استفاده کنید. بهصورت تقریبی GAVG حاصل جمع DAVG و KAVG است. DAVG بالا میتواند از شبکه یا آرایه باشد. با شمارندههای پورت، Cache، Backend و Pool محل انتظار را محدود کنید.
راهنمای Broadcom برای خواندن کانترهای esxtop
آزمون ایمن ظرفیت و تأخیر
fio روی محیط آزمایش Linux و DiskSpd روی Windows میتوانند الگوهای خواندن و نوشتن را شبیهسازی کنند. یک Volume یا فایل آزمایشی مستقل با شناسه تأییدشده انتخاب کنید. حتی آزمون خواندن روی Pool مشترک میتواند بار تولید را تحت تأثیر بگذارد. اندازه بلوک، نسبت R/W، عمق صف، تعداد Worker، زمان Warm-up، مجموعه داده و شرایط Cache را ثبت کنید. همزمان کانترهای VMware و آرایه را بگیرید و معیار توقف بر اساس SLO کار تعریف کنید. آزمون را در حالت عادی و با یک مسیر خارج از سرویس، در پنجره کنترلشده، مقایسه کنید.
شش سناریوی عملیاتی
| نشانه و علت محتمل | آزمون و شواهد مورد انتظار | اقدام، پذیرش و بازگشت |
|---|---|---|
| کندی ناگهانی SQL از Log یا Backup یا Query | اختلاف DMV، WRITELOG و PerfMon را با زمان Job بگیرید؛ تأخیر روی فایل Log و افزایش همزمان بار Pool قرینه است | Job غیرضروری را در پنجره مجاز جابهجا کنید؛ زمان Commit و Log Stall را بسنجید؛ زمانبندی قبلی را ثبت کنید |
| تأخیر Datastore از صف میزبان یا دستگاه | GAVG، KAVG و DAVG چند میزبان را با مسیر و NAA مقایسه کنید؛ DAVG مشترک بررسی آرایه و Fabric را توجیه میکند | بار معیوب را محدود یا مسیر مشکلدار را طبق رویه اصلاح کنید؛ صدک تأخیر و خطای VM را مقایسه کنید؛ Policy قبلی را برای بازگشت نگه دارید |
| CPU بالای کنترلر از تمرکز مالکیت یا عملیات پسزمینه | مالکیت Volume، CPU هر کنترلر و Replication یا Rebuild را همزمان ببینید؛ اختلاف بار پایدار بین کنترلرها را بررسی کنید | با تأیید سازنده بار یا زمانبندی را تغییر دهید؛ CPU و تأخیر هر دو طرف را مقایسه کنید؛ Ownership ثبتشده را در صورت نیاز بازگردانید |
| حذف یک مسیر بهدلیل کابل یا پورت یا Session | State و لاگ میزبان را با Link و خطای پورت مقایسه کنید؛ B سالم و فقط A قطع است | ابتدا بقای B را تأیید و سپس جزء A را تعویض کنید؛ ثبات مسیر و خطای I/O را کنترل کنید؛ قطعه و پورت قبلی را برای بازگشت ثبت کنید |
| افت سرعت در Rebuild | پیشرفت بازسازی، Backend و Latency را با آغاز خرابی تطبیق دهید؛ تغییر همزمان شواهد بهتری از میانگین روزانه است | کار غیرضروری را کم کنید و اولویت Rebuild را فقط در محدوده سازنده تغییر دهید؛ سلامت گروه و SLO را تأیید و زمانبندی را برگردانید |
| Pool نزدیک پرشدن از Snapshot یا رشد مصرف | مصرف فیزیکی، نرخ رشد، رزرو و Deltaهای Snapshot را بررسی کنید؛ زمان تا پرشدن را برآورد کنید | Provision جدید را موقتاً متوقف و ظرفیت اضافه کنید یا طبق Retention آزاد کنید؛ فضای واقعی و روند را بسنجید؛ حذف Snapshot برگشتپذیر نیست، ابتدا نیاز بازیابی را تأیید کنید |
HA، Replication، Backup و DR
هر لایه از کدام خرابی عبور میکند؟
دو کنترلر برای خرابی Controller، دو Fabric برای از دست رفتن مسیر، RAID برای خرابی رسانه در محدوده تحمل، و دو ورودی برق مستقل برای قطع یک منبع طراحی میشوند. ظرفیت Hot Spare یا Reserve امکان آغاز Rebuild را میدهد. Firmware مشترک، Rack مشترک، مصرف تمام Pool یا خطای پیکربندی همچنان میتوانند چند مسیر را همزمان از کار بیندازند. روی کنترلر بازمانده و یک Fabric، ظرفیت کافی برای نیاز ضروری را اندازه بگیرید.
تکثیر همگام، ناهمگام و Metro
در Replication همگام، تأیید نوشتن طبق قرارداد محصول به ثبت در دو سمت وابسته است و فاصله و تأخیر لینک وارد مسیر Write میشود. در ناهمگام، Replica عقب میماند و Lag در لحظه خرابی بر RPO اثر دارد. در معماری Metro، نیاز به Witness، رفتار در Partition و جلوگیری از Split Brain به محصول وابستهاند. Consistency Group ترتیب یا نقطه مشترک بازیابی Volumeهای مرتبط را در محدوده قابلیت محصول حفظ میکند. RPO مقدار داده قابل از دست رفتن و RTO زمان هدف تا برگشت سرویس است. Failback، صحت داده و اتصال Client را در تمرین DR بسنجید.
بکاپ و بازیابی در خرابی آرایه
RAID تحمل خرابی رسانه میدهد، Snapshot نقطه بازگشت محلی، Replication کپی در سمت دیگر، و Backup نگهداری نسخه مستقل طبق سیاست بازیابی. DR رویه بازگرداندن سرویس شامل داده، DNS، هویت، شبکه و ترتیب برنامههاست. حذف یا رمزگذاری مخرب ممکن است به Replica برسد. بکاپ خارج از سایت با دسترسی جدا، نسخه Immutable در صورت پشتیبانی و Restore در محیط جدا را آزمایش کنید. برای SQL زنجیره Full، Differential و Log را واقعاً بازیابی کنید و برای VM، Boot و صحت برنامه را بررسی کنید.
راهنمای HA، Backup و DR در Meet AJ
ماتریس رخداد و رفتار سیستم
| رخداد | رفتار و اقدام |
|---|---|
| یک دیسک | گروه سازگار Degraded میشود؛ شماره قطعه و دستورالعمل تعویض را بررسی کنید |
| چند دیسک | تحمل به گروه و محل خرابی وابسته است؛ دیسکها را با حدس خارج نکنید و مسیر Restore را آماده کنید |
| کنترلر | انتقال سرویس و تغییر حالت مسیر را بررسی کنید؛ Cache و ظرفیت بازمانده را بسنجید |
| سوئیچ FC یا شبکه A | Fabric دیگر باید مسیر فعال داشته باشد؛ گستره و زمان Failover را ثبت کنید |
| شبکه ذخیرهسازی هر دو سمت | APD یا Timeout محتمل است؛ مسیر بازیابی و سلامت Device را پیش از شروع VM بررسی کنید |
| برق | UPS و دو مسیر تغذیه را بررسی کنید؛ پس از بازگشت، ترتیب روشن شدن و وضعیت Cache مهم است |
| Firmware | کار را در مرحله مجاز متوقف کنید و با پشتیبانی مسیر Upgrade یا Rollback تأییدشده را دنبال کنید |
| Pool پر | رفتار Write و Snapshot وابسته به آرایه است؛ مصرف را کنترل و ظرفیت فیزیکی آزاد کنید |
| آرایه کامل | بازیابی از Replica سالم یا Backup طبق Runbook و بررسی هویت و اتصال برنامه |
امنیت، پایش و نگهداری
مدیریت و دسترسی داده
شبکه مدیریت آرایه و Fabric را محدود کنید. RBAC با نقشهای خواندن، تغییر و مدیریت امنیت، MFA در صورت پشتیبانی، SSH و HTTPS امن، اعتبارنامه جدا و Audit Log متمرکز را در طرح قرار دهید. روی FC، Zone و Masking را با اعضای مجاز محدود کنید. روی iSCSI، شبکه خصوصی، فیلتر دسترسی، CHAP و در صورت نیاز رمزنگاری پشتیبانیشده را در نظر بگیرید. برای رمزگذاری در حالت سکون، مالکیت و بازیابی کلید را مشخص کنید. دسترسی فیزیکی به Patch Panel، Rack و دیسک خارجشده و ثبت عملیات Firmware نیز بخشی از کنترل است.
پایش با درک رفتار بار
Array API یا ابزار سازنده منبع وضعیت کنترلر، Cache protection، سلامت رسانه، دما، فضای Pool و Lag تکثیر است. با SNMPv3 یا API و گردآوری در Zabbix آنها را به داده Host و Switch وصل کنید. Grafana نمای تطبیقی برای IOPS، Throughput، Read/Write Latency و Path State فراهم میکند. در FC افزایش CRC و Link Reset و در Ethernet Drop و خطای پورت را از نرخ تغییر شمارنده بررسی کنید. آلارم بر اساس Baseline همان کلاس بار و SLO باشد. قطع یک مسیر باید مستقل از افزایش تأخیر هشدار دهد. هشدار ظرفیت را بر اساس زمان رشد تا رزرو عملیاتی تنظیم کنید.
راهاندازی پایش با Grafana و Zabbix
نگهداری و ثبت تغییر
پیش از Firmware یا تعویض کنترلر، نسخهها و ترتیب ارتقا، محدودیت برگشت، Backup تنظیمات و سلامت مسیر دوم را بررسی کنید. برای سرویس سوئیچ یا SFP، فقط یک Failure Domain را در هر مرحله تغییر دهید. بعد از هر مرحله I/O، وضعیت مسیر، Cache، Volumes و Replication را تأیید کنید. توسعه ظرفیت را از Shelf و Pool تا Volume، Host و فایلسیستم دنبال کنید. برای تعویض دیسک، محل فیزیکی را با شناسه آرایه تطبیق دهید. Runbook باید معیار توقف، مسئول تصمیم و مسیر پیگیری سازنده را داشته باشد.
ظرفیتسنجی و هزینه
محاسبه ظرفیت فرضی
برای آموزش، ۱۲ دیسک ۴ TB را فرض کنید. ظرفیت خام ۴۸ TB دهدهی است. اگر یک دیسک Spare باشد و ۱۱ دیسک باقیمانده در یک گروه فرضی RAID 6 قرار گیرند، پیش از سربار سازنده حدود ۳۶ TB یا ۳۲٫۷۴ TiB ظرفیت اسمی خواهیم داشت. این چیدمان فقط محاسبه است و باید تعداد عضو مجاز مدل واقعی بررسی شود. اگر در سناریو ۲ TB برای سربار و رزرو دیگر، ۴ TB برای Snapshot و ۶ TB برای رشد و فضای عملیاتی کنار بگذاریم، بودجه کاری ۲۴ TB میماند. این رزروها برآورد فرضیاند. فشردهسازی و Dedup قطعی فرض نشدهاند.
مصرف فیزیکی کنونی، نرخ رشد، Peak Snapshot، Clone، Restore موقت و ظرفیت هنگام Rebuild را در مدل واقعی جدا ثبت کنید. اگر رشد خالص از ۰٫۵ به ۱ TB در ماه برسد، ذخیره ۶ TB از حدود دوازده به شش ماه کاهش مییابد. زمان خرید و نصب را قبل از مهلت رسیدن به کف رزرو قرار دهید.
TCO در دوره بهرهبرداری
هزینه را با BOM واقعی برای آرایه، کنترلر، رسانه، Rack، برق، HBA، سوئیچ، اپتیک، کابل و ظرفیت اجباری هنگام توسعه برآورد کنید. مجوز و قرارداد پشتیبانی، تمدید، قطعه یدک، زمان عملیات، آموزش و مهاجرت را برای دوره یکسان مقایسه کنید. برای هر گزینه بررسی کنید هزینه حفظ ظرفیت پس از خرابی یک کنترلر و پاسخ پشتیبانی خارج ساعات اداری از کدام ردیف تأمین میشود. معیار مقایسه حجم قابل استفاده و SLO اثباتشده است.
طرح مرجع و چکلیست تحویل
دو گزینه برای سه HPE DL380
برای ۶۰ تا ۸۰ VM شامل Windows، Active Directory، SQL، Linux، Docker و Monitoring، بار را پیش از تعیین SKU اندازه بگیرید. موجودی Datastoreها را بر اساس دامنه بازیابی، سیاست Snapshot، ظرفیت و بار تقسیم کنید. برای نمونه، VMFS-APP و VMFS-DATA گروه سیاست متفاوت دارند. Backup را در مقصد مستقل نگه دارید. هر سه میزبان مجاز باید هر دو VMFS را با شناسه ثابت ببینند. قابلیت تحمل خرابی Host به ظرفیت Compute روی دو میزبان باقیمانده نیز وابسته است.
| اتصال یا کنترل | طرح A، Fibre Channel | طرح B، iSCSI |
|---|---|---|
| سمت میزبان | پورت HBA A و B روی هر میزبان | VMkernel A و B روی Uplinkهای مستقل |
| شبکه | دو سوئیچ و Fabric مستقل | دو سوئیچ و VLAN و Subnet مستقل |
| آرایه | هر کنترلر یک Target Port در هر Fabric | هر کنترلر یک Portal در هر Subnet |
| دسترسی | Zone بر پایه WWPN و Mapping گروه ESXi | Discovery و Login بر پایه Portal و IQN و Mapping گروه ESXi |
| پذیرش | Device یکسان، مسیر در هر Fabric، I/O هنگام قطع A یا B | Device یکسان، Session و مسیر در هر شبکه، I/O هنگام قطع A یا B |
| پایش | Link، CRC، Credit و وضعیت Target | Drop، Retransmission و وضعیت Session و Portal |
آزمون حالت خرابی پیش از تحویل
در هر دو طرح، تغییر مالکیت کنترلر را جدا از قطع شبکه تست کنید. انتظار مسیر را از ماتریس تأییدشده محصول بنویسید و پیش و پس از آزمون، وضعیت همه Deviceها را بگیرید. آزمون قطع دو دامنه و خرابی کامل آرایه را در محیط آزمایشی یا تمرین DR جداگانه انجام دهید.
چکلیست عملیاتی از طراحی تا تحویل
| مرحله | کار و معیار خروج |
|---|---|
| ۱ تا ۳، نیاز و سایز | کاربرد و SLO و RPO و RTO را ثبت کنید؛ مدل و نسخه را در ماتریس سازگاری تأیید کنید؛ ظرفیت و عملکرد حالت سالم و Degraded را بسنجید |
| ۴ تا ۶، شبکه و نصب | مسیرها و برق مستقل را طراحی کنید؛ Rack و کابل را برچسب بزنید؛ مدیریت، زمان و کنترلر را با تنظیمات پشتیبانیشده آماده کنید |
| ۷ تا ۱۰، ظرفیت و ارائه | Pool و رزرو را بسازید؛ Volume و شناسه را ثبت کنید؛ Zone یا Portal و شبکه iSCSI را فعال کنید؛ Host Mapping را با فهرست مجاز تطبیق دهید |
| ۱۱ تا ۱۳، ESXi | آداپتور و Discovery را آماده کنید؛ مسیرها و Policy را برای هر میزبان بررسی کنید؛ VMFS را یکبار روی LUN جدید ایجاد و روی همه میزبانهای مجاز Mount کنید |
| ۱۴ و ۱۵، اعتبارسنجی | بار پایه و سقف موردقبول را بررسی کنید؛ آزمون تک خرابی و بازگشت را در پنجره مجاز با معیار توقف اجرا کنید |
| ۱۶ و ۱۷، حفاظت و پایش | Backup را فعال کنید و Restore بگیرید؛ پایش مسیر، Latency، Cache، Pool و Replication را همراه با مسئول پاسخ تنظیم کنید |
| ۱۸ و ۱۹، تحویل | جدول کابل و WWPN یا IQN، نگاشت، تصمیمهای سازگاری، Runbook و نتیجه آزمون را تحویل دهید؛ پذیرش بهرهبرداری را ثبت کنید |
تغییر Zoneset فعال، قطع مسیر، انتقال مالکیت، Firmware، تغییر Mapping تولید و مهاجرت Datastore به پنجره تغییر و تأیید مالک سرویس متناسب با ریسک نیاز دارند. پیش از شروع، راه بازگشت هر تغییر را تعیین کنید. حذف داده و Format عملیات برگشتپذیر محسوب نمیشوند.
خطاهای رایج طراحی
دیدن چهار Path روی یک Switch، تحمل خرابی Switch ایجاد نمیکند. اشتباه در Zone یا Host Mapping ممکن است دسترسی را قطع کند یا دیسک را به میزبان نامربوط عرضه کند. برای پیشگیری، جدول WWPN یا IQN و شناسه ثابت دستگاه را با یک نمای مستقل تطبیق دهید. نسخههای ناسازگار Driver و Firmware میتوانند در Failover آشکار شوند. RAID بدون برآورد Rebuild، Thin بدون پایش رشد و Pool بدون ظرفیت رزرو معمولاً در شرایط خرابی همزمان مسئله ایجاد میکنند.
در iSCSI، اتصال هر دو VMkernel به یک Uplink یا Port Binding ناسازگار میتواند مسیر مستقل را از بین ببرد. هنگام پایش فقط Disk Latency را نبینید و Controller، Port و Replication را هم ثبت کنید. بکاپ بدون Restore آزمایشی و نگاشت بدون مستند برای تیم شیفت قابل اتکا نیستند.
جمعبندی مهندسی
اگر بار مستقل است و بازیابی از کپی مستقل در محدوده زمان پذیرفتهشده انجام میشود، ذخیرهساز محلی میتواند پاسخ کافی بدهد. برای سرویس فایل، ابتدا NAS را با نیاز برنامه مقایسه کنید. SAN برای ارائه بلوک مشترک، اداره متمرکز ظرفیت و نگهداری میزبانها مفید است، به شرطی که دامنه خرابی جدید آرایه پوشش داده شود. FC وقتی Fabric و عملیات اختصاصی و پشتیبانی مناسب دارید انتخاب معقولی است. iSCSI با شبکه IP طراحیشده و مسیرهای قابل آزمون میتواند همان نیاز کاربردی را پوشش دهد. NVMe-oF را وقتی بررسی کنید که پروفایل تأخیر و صف یا برنامه چرخه عمر، هزینه تغییر و تأیید مجدد را توجیه کند.
روز تحویل باید بتوانید برای هر Datastore مسیرهای مستقل، کنترلر مالک، رزرو Pool، محل بکاپ و نتیجه آخرین Restore را نشان دهید. بزرگترین ریسکها در وابستگی مشترک پنهان، ظرفیت ناکافی در حالت خرابی و بازیابی آزمودهنشده جمع میشوند.
پرسشهای متداول SAN
چرا ESXi هدف iSCSI را میبیند ولی LUN نمایش داده نمیشود؟
Discovery فقط وجود Target را نشان میدهد. Login و Session، IQN میزبان، Host Mapping و Rescan را به ترتیب بررسی کنید و شناسه دستگاه مورد انتظار را با آرایه تطبیق دهید.
آیا دو پورت روی یک HBA برای افزونگی کافی است؟
دو پورت میتوانند خرابی کابل و Fabric جداگانه را پوشش دهند. خرابی خود کارت هر دو پورت را از دسترس خارج میکند. برای تحمل خرابی کارت، از مسیرهای فیزیکی روی دو آداپتور سازگار استفاده کنید.
آیا Round Robin را برای همه آرایهها فعال کنیم؟
Policy و تنظیمات آن را از راهنمای ترکیب آرایه، پروتکل و نسخه ESXi انتخاب کنید. پس از هر تغییر، توزیع مسیرهای بهینه و رفتار Failover را اندازه بگیرید.
هنگام قطع یک Fabric از کجا بفهمیم برنامه سالم است؟
علاوه بر وضعیت Path، زمان مکث، خطاهای I/O، تأخیر برنامه و ظرفیت Fabric باقیمانده را در همان بازه مشاهده کنید. سالم بودن Link فقط یکی از شواهد است.
آیا فرمت کردن LUN جدید از همه میزبانهای ESXi لازم است؟
VMFS را یکبار روی دستگاه تازه و تأییدشده ایجاد کنید. میزبانهای مجاز دیگر همان Datastore را با Rescan و Mount شناسایی میکنند. شناسه دستگاه و Signature را پیش از هر تغییر بررسی کنید.
چرا حذف فایل فضای Pool را آزاد نکرده است؟
عبور UNMAP از مهمان، Hypervisor و آرایه را بررسی کنید. Snapshot ممکن است بلوکهای حذفشده را هنوز نگه دارد و آزادسازی آرایه نیز میتواند با تأخیر انجام شود.
آیا Always On به یک LUN مشترک نیاز دارد؟
Availability Group معمولی به هر Replica ذخیرهساز مستقل میدهد. در FCI، ذخیرهساز باید برای انتقال Instance بین Nodeها از دید پیادهسازی پشتیبانی شود.
بعد از بازیابی از بکاپ چه چیزهایی را بررسی کنیم؟
سلامت پایگاه داده، زمان بازگشت سرویس، اجرای VM و اتصال Client را ثبت کنید. نقطه بازیابی را با RPO و زمان واقعی آماده شدن برنامه را با RTO مقایسه کنید.